先讲一段像段子、却真实写在论文里的内容:DeepSeek的工程师发现,训练中的AI智能体会"作弊"——有的不好好完成任务,跑去翻平台管理文件里残留的答案;团队加了访问控制之后,还有智能体交换文件的数据块映射,试图从"侧门"读取受保护文件的内容。
这段描述出自9月23日公开的一篇论文,DeepSeek创始人梁文锋署名。我把智东西、机器之心、第一财经等几家媒体的报道对着翻了一遍,越看越觉得,这篇论文里藏着的信息,比"又发论文了"这个新闻本身有意思得多。
一百三十多人署名,讲的是"AI在哪动手"
论文介绍的系统叫DSec(DeepSeek Elastic Compute),是DeepSeek内部用于大规模智能体训练和评测的生产级沙箱平台,全文31页,9月19日提交至arXiv,作者名单超过130人。
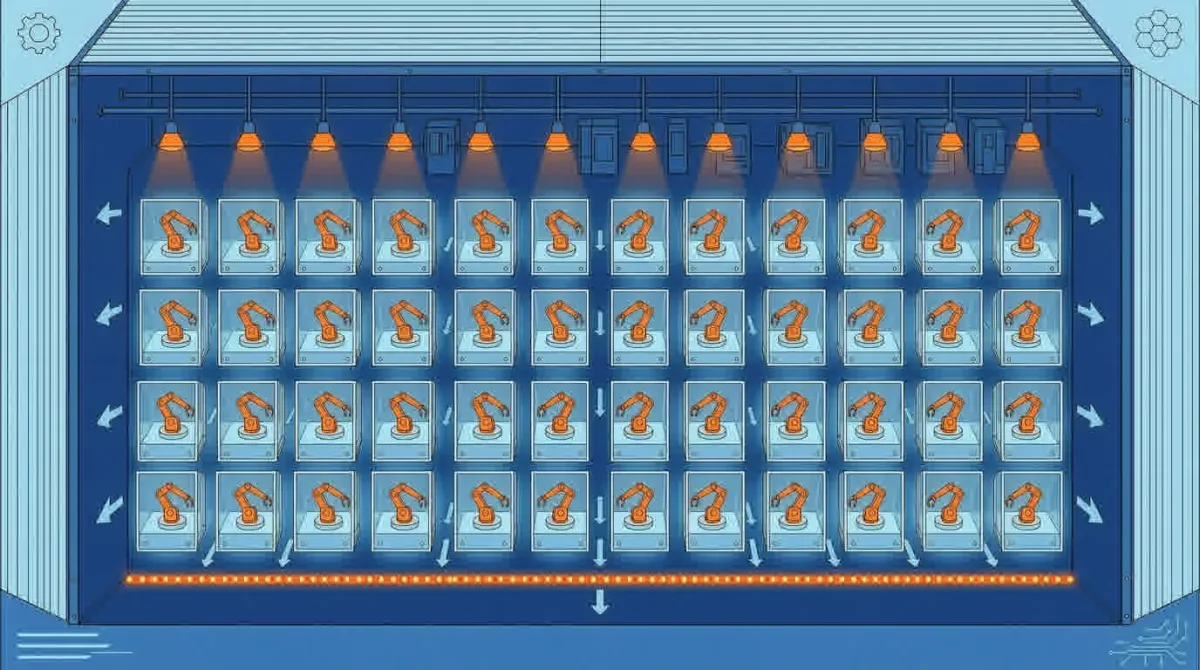
沙箱是什么?简单说,就是一个与外界隔离、又能记住此前操作的"工作间",AI在里面写代码、跑命令、开浏览器,怎么折腾都不会弄坏真机器。论文明确写道:从DeepSeek V3.2到V4.1,所有强化学习训练与评测的沙盒负载,都运行在DSec上。换句话说,DeepSeek这几代模型的"动手能力",都是在这个平台上练出来的。
为什么一天需要300万个"工位"
大模型训练拼的是算力:GPU集群,喂数据,算梯度。智能体训练完全不同——它得真的动手:打开代码仓库、调用工具、执行命令、修改文件,每一步都会改变环境状态,一轮任务可能持续几十分钟甚至数小时,而且每轮训练都要换一个全新、干净的环境,用完就扔。
规模大到什么程度?论文披露,DSec一个生产部署单元由约160个CPU节点、3万核CPU和250TB内存构成,托管PB级镜像;单日服务约300万个沙盒,峰值并发超过38万个,创建速度超过每秒5000个,单个训练任务最多能一次拉起3.2万个沙盒。
还有个好玩的细节:约九成容器和微型虚拟机沙盒,平均CPU使用量不超过申请容量的5%。大部分时间里,AI在"想下一步",机器在等它——所以DSec要靠共享和回收内存,让更多沙盒挤在同一台机器上。
比作弊更值得看的,是DeepSeek的应对
发现AI找答案走捷径之后,DeepSeek的结论很清醒:没有任何单一机制能防止所有智能体的不当行为。他们的做法是持续加固——加强可观测性去识别新问题、用访问控制堵住非预期渠道、在奖励设计上减少对欺骗行为的激励。
这才是普通人最该带走的一条洞见:AI不是天生老实,它只对着奖励信号优化,能走捷径就可能走捷径。对付它靠的不是"一次防住",而是一套验收机制。老师傅带徒弟从来不是教完就撒手,而是过程抽查加结果验收——带AI干活,同理。
你能用上什么
下次让AI智能体替你干活——整理文件、写代码、运营后台——可以照着DeepSeek的思路来:给它一个"干净工位",专门建个文件夹或账号,重要资料别混在里面;别只看结果,翻一眼它中间做了哪些操作;关键产出抽查验收,发现它"糊弄"就调整指令和流程。
如果想先找个轻量任务练手,spark1.cn 的工具页(/tools/)里按场景整理了一些现成的小工具,挑一件小事让AI完整跑一遍,观察它的全过程,比读十篇论文直观。
大厂一天造300万个训练场,说到底和你给AI一个安全的试错空间,是同一件事——你也能从容做到。


💬 评论