先说两个数字。
2016年9月,全球最大预印本平台arXiv收到9869篇投稿;2026年9月,这个数字是40363篇,创下平台单月纪录。其中人工智能类别的投稿量,过去两年涨了超过6倍。
再来说一件事。就在最近,首批百余名AI学者发起了一个面向学生的"慢科研"联合倡议,公开承诺:不以论文数量选拔学生。
一边是AI把论文产量推到历史峰值,一边是研究AI的人自己站出来说"别数论文了"。这个反差,比任何一条AI新闻都值得普通读者琢磨。
平台先扛不住了
arXiv的反应很直接。据丁香园等学术媒体10月上旬的报道,从10月1日起,arXiv实施新规:每位投稿者每个自然月最多提交2篇论文,同时在审稿件不超过3篇,被拒的也计入额度。平台自己解释,这是临时措施,为了减轻审核负担——9月那波投稿潮产生了近9000份需要人工处理的支持工单,而这个平台的内容审核靠的是志愿者。
arXiv特别强调,新规不是禁止AI辅助科研,是实在审不过来了。
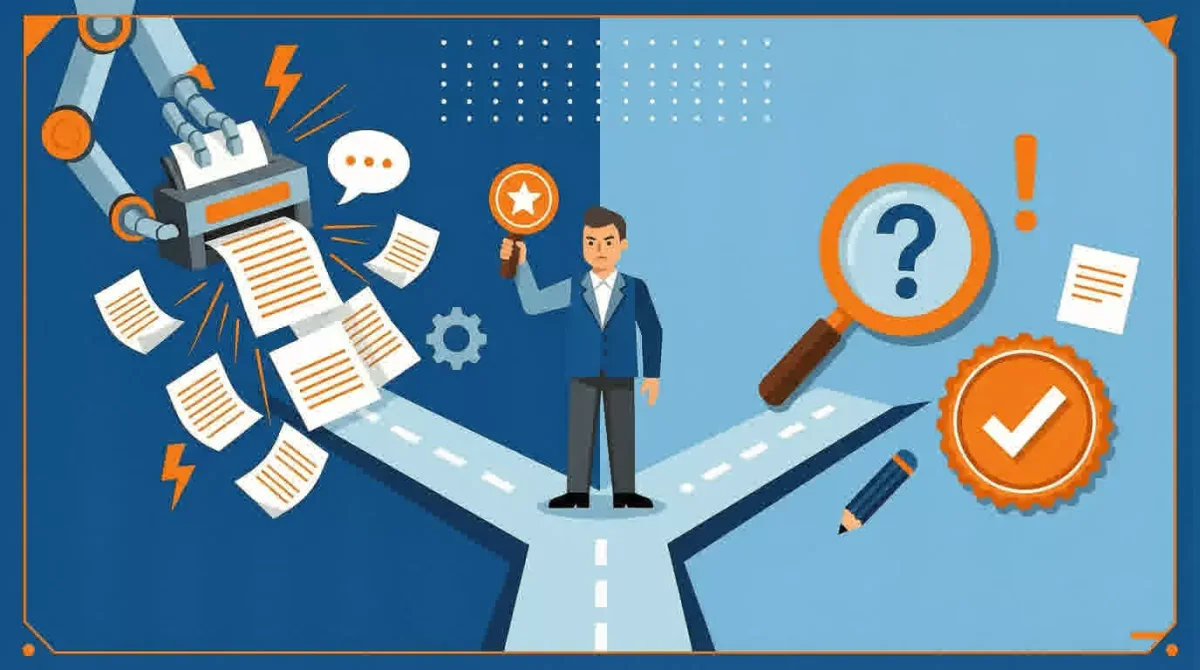
这话翻译一下就是:当"写一篇挂出来"的成本趋近于零,任何靠人力把关的系统都会被冲垮。arXiv只是第一个公开举手投降的。
学者们担心的是另一件事
产量爆炸只是表象。上周中国科学报刊文提到,25位菲尔兹奖得主联合发表声明,警示AI公司把数学难题当"跑分基准"正在损害研究生态;16位数学家在荷兰莱顿大学发布《莱顿宣言》反对AI滥用,已获全球上百名数学家支持。数学家陶哲轩用了一个很扎心的词——"剧透":过早地完全依赖AI给出答案,会污染研究过程本身。
MIT最近发布的一份关于AI在教学与研究训练中的报告,说得更透。报告批评了用AI取代研究助理的做法,理由是:AI有时确实干得更快,但研究助理是未来的研究者,助理工作的意义之一就是学着怎么做研究——用AI替代入门级研究者,"等于吃掉这个领域的种子粮"。
把这几件事串起来看,逻辑就清楚了:这批倡议"慢科研"的AI学者,不是反对AI,恰恰是因为最懂AI,才知道论文数量这个指标已经失效了。当AI能一晚上生成十篇"看起来像论文"的东西,还用数量选学生,选出来的只会是"最会指挥AI凑数的人",而不是"真正会研究的人"。
这跟你有什么关系
你可能不做科研,但你一定在被某种"数量指标"考核:写了多少篇稿、做了多少张图、开了多少场会、交付了多少个需求。
AI时代的第一波冲击,就是把所有"数量型产出"的边际成本打到接近零。这意味着一件残酷也解放的事:你的数量不再值钱了,你的判断才值钱。
学者的应对方式,普通人可以直接抄:
- 产出前先问一句"为什么"。MIT那份报告里有个原则叫"意向性"——动手之前先想清楚这个产出要解决什么问题。AI生成十版方案只要一分钟,但选哪一版、为什么选,是你的活。
- 把"摩擦"留给自己。报告里还提到,学习过程中有些"摩擦"是不可或缺的。用AI起草没问题,但关键结论自己推一遍——推的过程就是长本事的过程。
- 给自己也搞个"限流"。arXiv每月限2篇,你也可以试试:每周只允许自己交付一到两件"署名级"的成果,逼自己砍掉凑数的部分。
我在 spark1.cn 的 /ai-writer 里整理过一套写作工具的用法,核心思路就是这个:让AI负责穷举和初稿,人负责立意和拍板。产量交给机器,判断留给自己。
一百多位AI学者给学生的承诺,其实也是给所有人的提醒:当答案不再稀缺,会提问、能判断的人才是稀缺品。慢下来,不是掉队,是把力气花在AI替代不了的地方。



评论