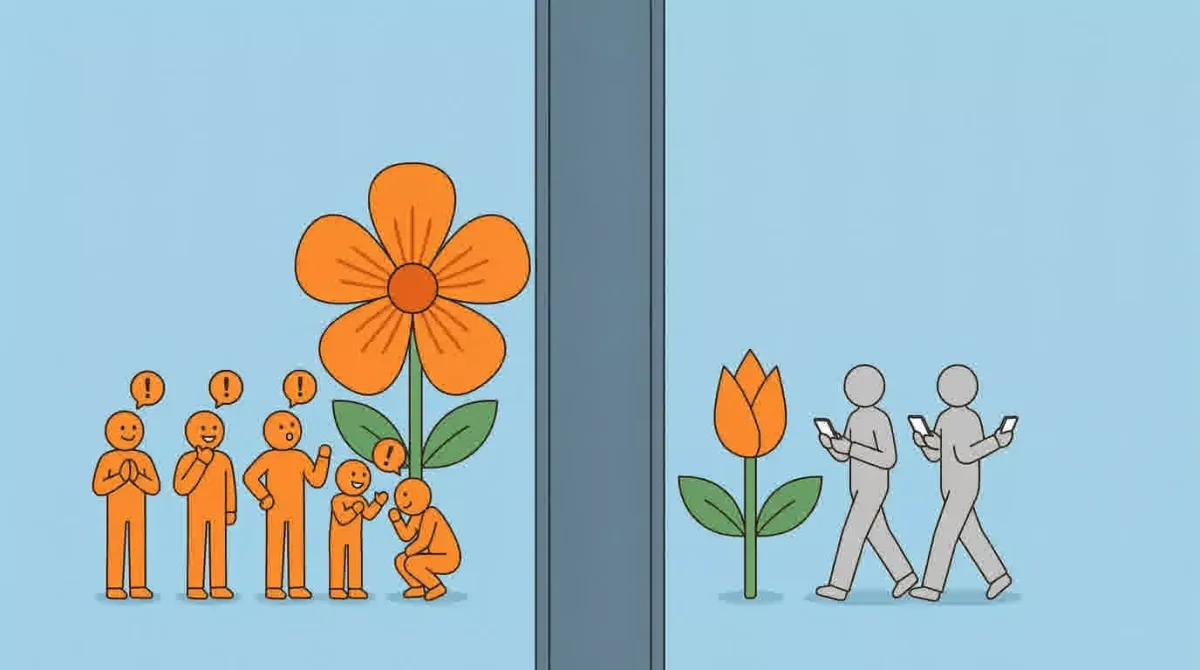
这两天我把两份材料翻出来对着看了一遍:一份是中信里昂刚发的智谱研报,一份是36氪10月20日的分析文章《智谱的困惑》。看完发现一个特别拧巴的现象——在海外,智谱的GLM系列被开发者社区捧得很高,开源榜单上常和Meta的Llama、法国的Mistral放在一起讨论;可在国内街头问一句"你知道哪些国产大模型",答案大概率是DeepSeek和豆包,智谱?非技术圈的人一脸茫然。
同一个模型,为什么墙内墙外是两个待遇?
先看研报里的硬数字
中信里昂这份报告调研了中国以外亚洲地区的1200名IT主管和经理,几个数字值得掰开看:
- 智谱模型在受访企业中的当前采用率只有1.8%;
- 但有5.1%的企业计划在未来6到12个月开始用GLM——如果意向全部兑现,客户基础接近扩大到现在的四倍,东盟六国最积极,计划采用率6.8%;
- 现有客户里,82%计划增加GLM相关开支,这个比例高于Anthropic的77%和DeepSeek的55%;
- 77%的客户认为换用其他模型的转换成本"中等至显著",82%已经在GLM基础上训练或微调了自己的模型;
- 里昂因此重申"跑赢大市"评级,目标价1907港元。
翻译成人话:用的人还不多,但用上的人黏性极高、还愿意加钱。这在生意场上是个很健康的信号——渗透率低意味着天花板远,黏性高意味着护城河已经挖出来了。
那为什么国内大众没感觉?
36氪那篇分析给了个很准的判断:这不是技术不行,而是技术实力、商业路径和大众认知之间的错位。
智谱脱胎于清华大学计算机系知识工程实验室,自带"学术精英"基因,早期路径是重研发、重底层架构、重企业和政府客户。海外开发者社区恰恰吃这一套——他们看论文质量、看开源程度、看API稳不稳定。GLM在这些硬指标上做得扎实,还登顶过Hugging Face趋势榜,轻量化模型上线两周下载量破百万。
但国内大众市场的评价标准完全是另一套:不关心你参数多大、跑分多高,只关心"能不能帮我写文案、做攻略、陪我聊天"。谁的产品离普通人的日常场景近,谁就有认知度。DeepSeek和豆包赢在这一层,不是赢在实验室里。
这件事对普通人的真正用处
抛开股价和八卦,我觉得这里面藏着一个选AI工具的通用心法:知名度排行≠适合你的排行。
大众认知度是营销和场景覆盖堆出来的,而"好不好用"永远取决于你的具体任务。里昂报告里那77%的"转换成本"也提醒了另一面:企业选模型一旦深度绑定,再换就很疼。所以对个人来说,选模型的正确姿势其实就三步逻辑——
- 先定义任务:你是写代码、写公文、做表格,还是日常问答?不同模型的长板完全不同。
- 用真实任务去试:别信任何榜单,把你自己的活儿原样丢给两三个模型跑一遍,看谁交付的结果让你改得最少。
- 想清楚迁移成本:如果你打算长期使用,优先选生态开放、数据好导出的,别让自己变成那"77%"里被动的人。
我自己维护的 spark1.cn 上有个 /tools/ 工具目录,把常用的AI工具按场景分了类,闲的时候可以当"试菜台"用——同一个需求换个工具跑跑,很快就有体感了。
智谱的故事还在展开,海外那5.1%的意向能不能兑现,明年自有分晓。但对每一个用AI的人来说,结论早就摆在那了:模型没有"最强",只有"最配"。搞清楚自己的需求,你就永远能从从容容地挑到趁手的那一个。


评论