11 月 8 日晚上,一张脸刷了屏。到当晚 23 时 45 分,它排在百度实时热搜第 5 位;报道里说,相关话题还冲上了微博热搜第一。
点进去,是陕视新闻 11 月 8 日的一条报道:西北大学科研团队用颅面复原技术,还原了秦陵东侧上焦村陪葬墓中一名年轻男子的面容。男子死时约 30 岁,右颞骨嵌着一枚青铜箭头,头和四肢被肢解后置于棺内。专家推测,他大概率是秦始皇的儿子,死于秦二世胡亥的清洗。
复原图里,他有着橄榄形眼睛、高挺的鼻梁,面部轮廓与《史记》记载的秦始皇「蜂准、长目」有相似之处。
评论区最热的一句是「撞脸张鲁一」。但我盯着那张图看了很久,发现三件更值得说的事。
一、这张图上的字,和报道说的不是一回事
这篇报道在网易的转载页里只配了两张图。第二张就是全网在转的那张「复原图」——黑底、黄白大字,上面写着六行字:
- 秦始皇真实样貌
- 通过复原秦始皇儿子头骨
- 推断秦始皇高鼻梁细长眼
- 根据遗传基因分析
- 秦始皇可能真的如《史记》记载
- 高鼻梁、细长眼、鸡胸
问题就在这儿。
第一,被复原的是儿子,被推断的是父亲。 报道说的是复原这名年轻男子的面容;图上写的却是「秦始皇真实样貌」。一个头骨只能说明这个人的骨相,用它去推上一代人的长相,中间隔着一整套随机组合。这是两件事,被压成了一句话。
第二,「遗传基因分析」这个方法,在公开报道里找不到。 2018 年报道同一项目时,写明的方法是「深度学习算法和大型解剖数据库」。从颅骨到面容,走的是骨相约束加统计推断,不是基因检测。至少公开材料里,没有出现过基因这一环。
第三,用父亲的记载去验证儿子的脸,逻辑是循环的。 《史记》写秦始皇「蜂准,长目,挚鸟膺」——长鼻子、细长眼、鸡胸。这张海报把「鸡胸」也带上了。可复原的是儿子的头骨,儿子像不像父亲,本来就没有标准答案;拿父亲的文字记载来给儿子的复原图打分,等于先有结论再找证据。
二、这件事,2018 年 7 月就公开过
真正让我停下来的是另一件事:这套复原不是新的。
2018 年 7 月 16 日,参考消息网转载香港《南华早报》的报道,题目是《用科学揭开历史面纱:秦始皇嫔妃皇子面部复原图公开》。我把两篇报道的细节逐条对了一遍:
| 细节 | 2018 年报道 | 2026 年 11 月 8 日报道 |
|---|---|---|
| 墓葬位置 | 秦始皇陵东侧上焦村墓群 | 秦陵东侧上焦村陪葬墓 |
| 死因线索 | 右颞骨发现一枚青铜箭头 | 右颞骨嵌有青铜箭头 |
| 尸身状态 | 头和四肢与身体分开 | 头和四肢被肢解 |
| 年龄 | 30 岁上下 | 约 30 岁 |
| 五官 | 橄榄形眼睛、隆起的鼻子 | 橄榄形眼睛、高挺鼻梁 |
| 方法 | 深度学习算法、大型解剖数据库 | 报道未提方法 |
| 开发方 | 西北大学信息科学与技术学院(副教授李康) | 西北大学科研团队 |
七项里六项对得上。剩下那一项「方法」,新报道没有写。
也就是说,这不是一项 11 月 8 日才发布的新成果,而是一件八年前公开过的旧结果,在昨天被重新报道,然后上了热搜。八年前的报道里还提到,同一个墓群中一位约 20 岁的女性也被复原了面容,其特征「似乎不属于典型的汉族人」,暗示她可能有中亚甚至欧洲血统——这一条,昨天几乎没人提。
旧结果重新上热搜,本身不奇怪。奇怪的是一张八年前的复原图,今天被当成了「新发现」,还被换了主语、加了方法。
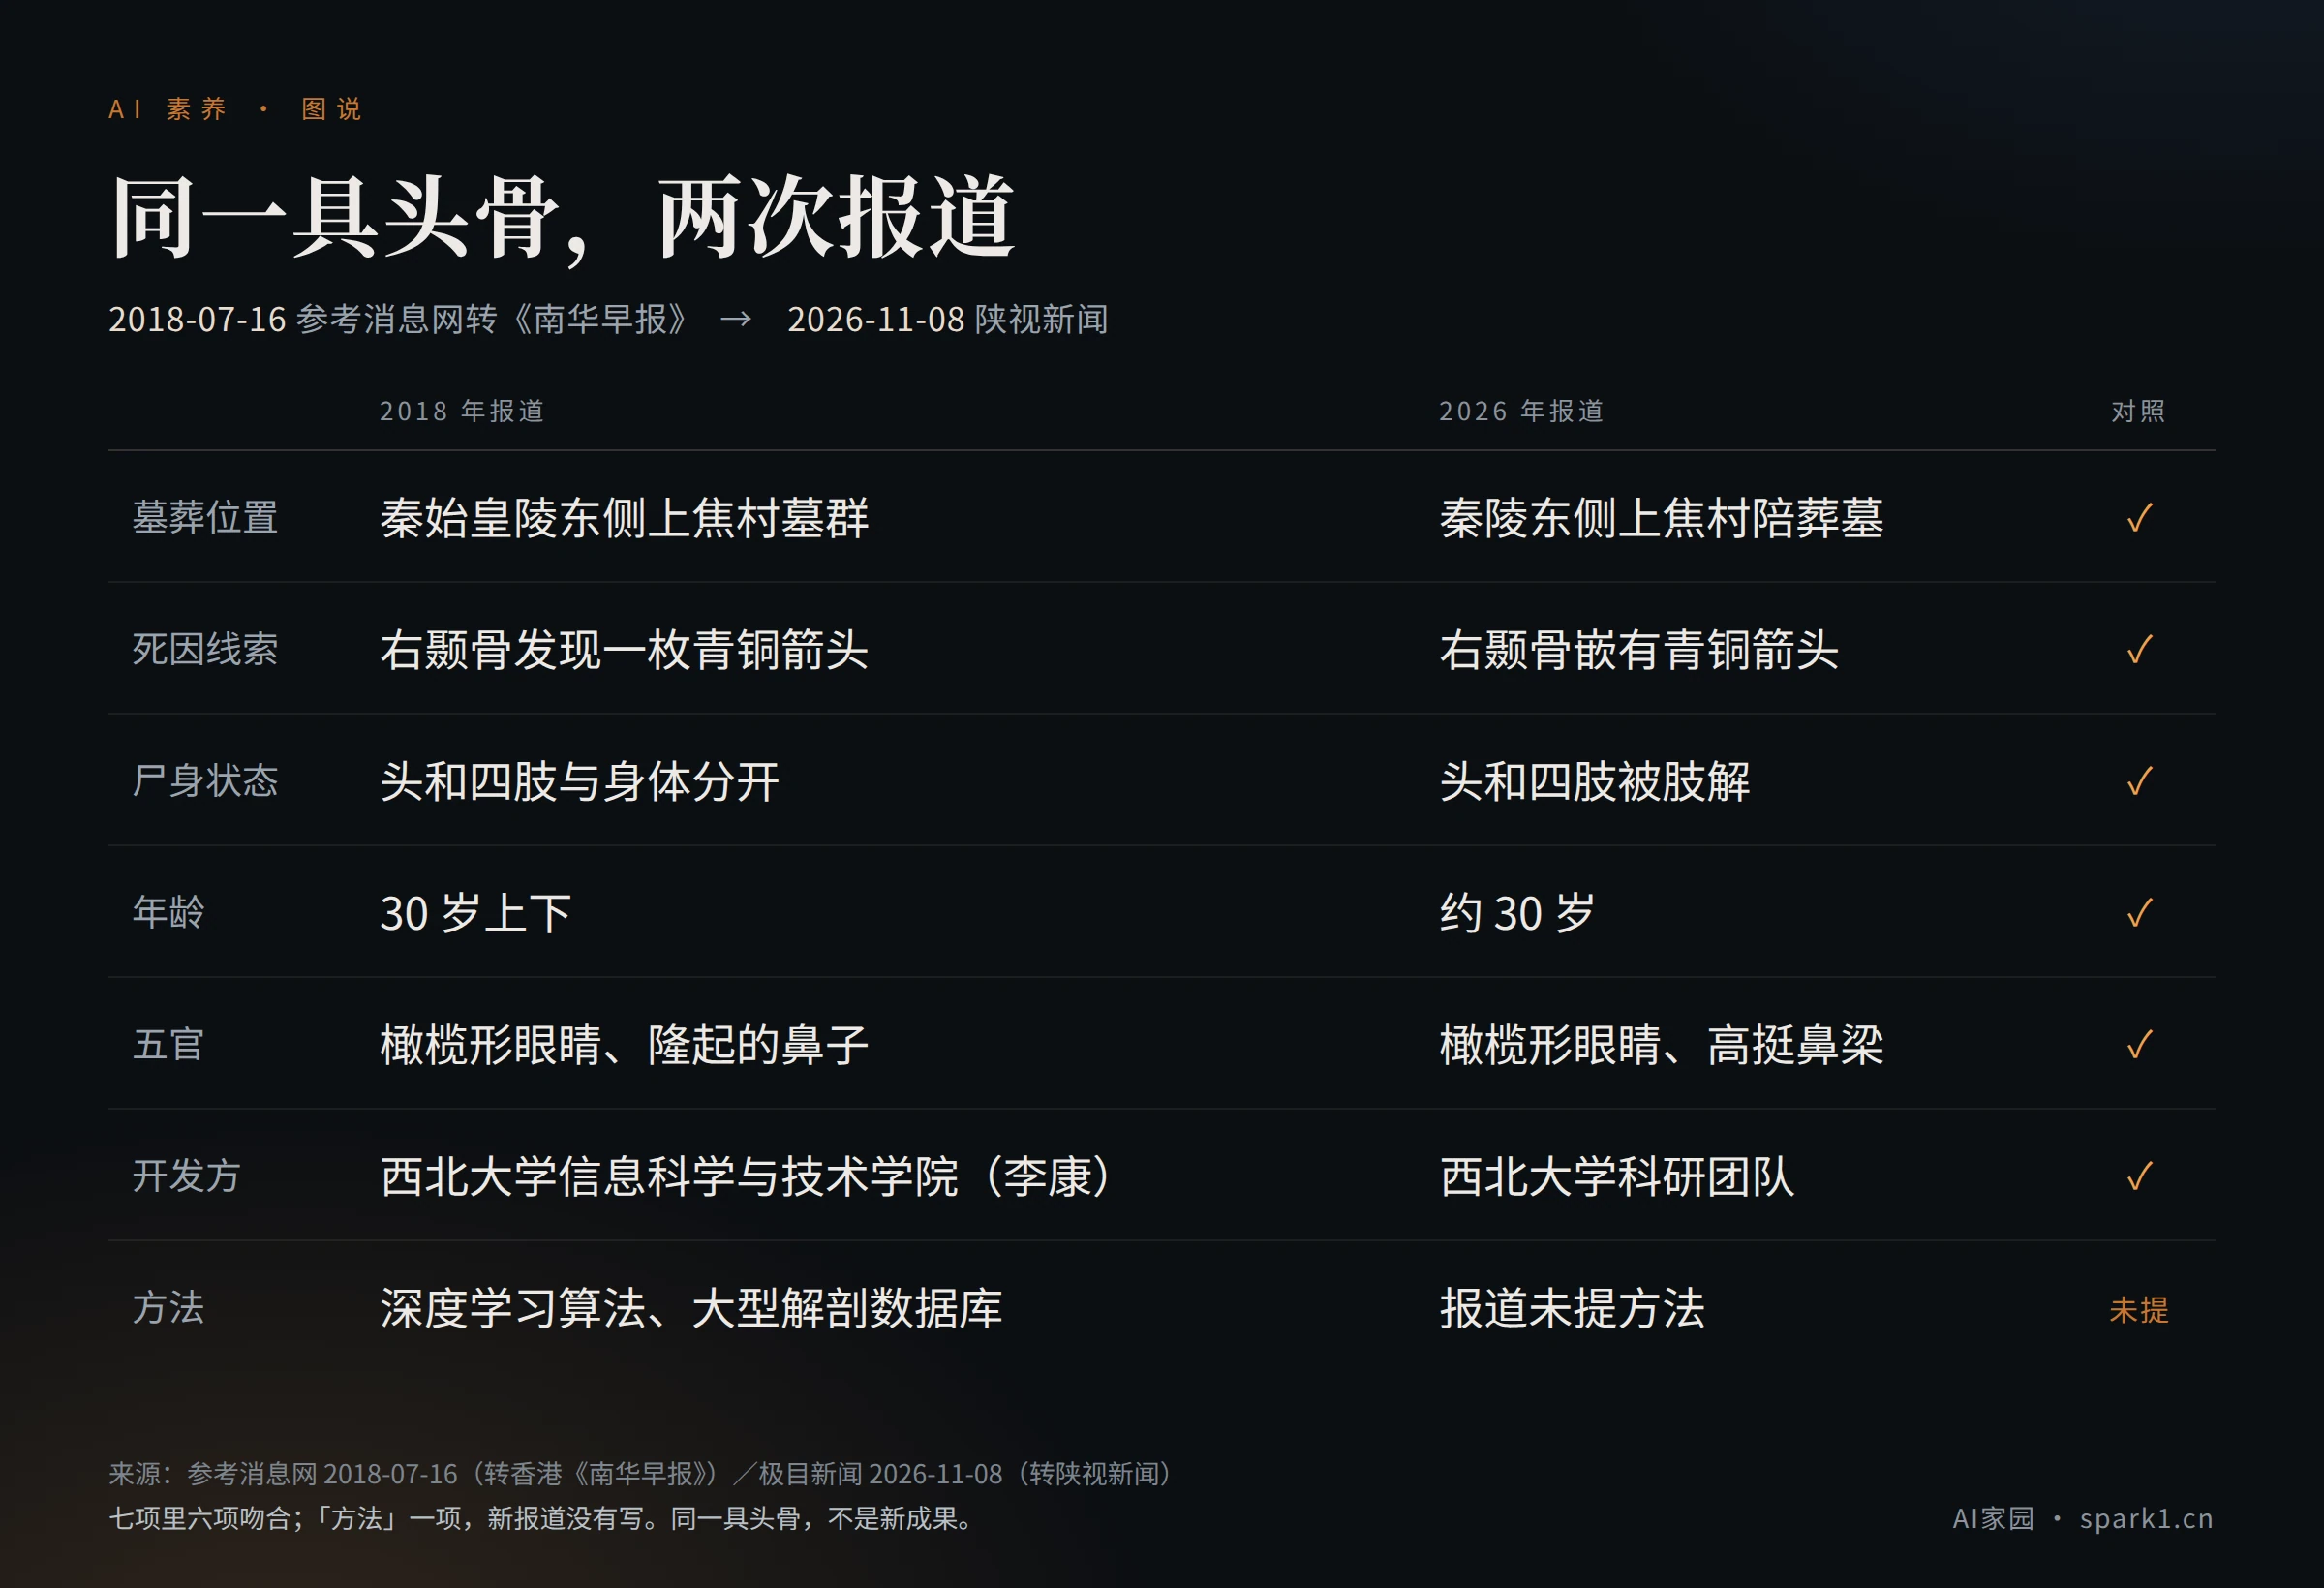
这张图可以直接存下来。下次再刷到「AI 复原某某长什么样」,先看三件事:是谁的头骨、被推断的是谁、原始报道是哪一年。
三、颅骨给轮廓,皮肉是算出来的
那这套技术到底能给出什么、不能给出什么?
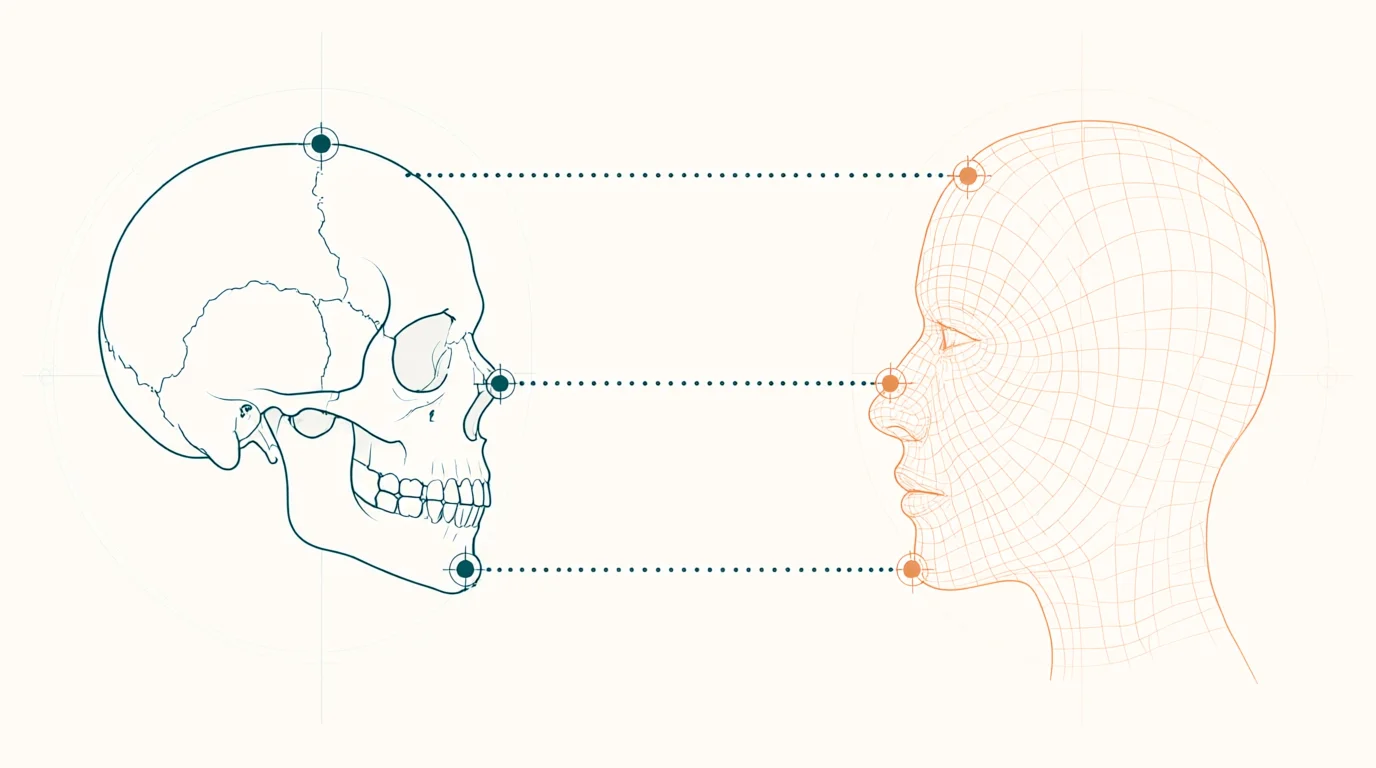
能给的,是硬约束。 颅骨是骨头,眼眶的位置、鼻根的高度、颧骨的宽度、下颌的角度,都实打实地长在那里。复原的第一步,是把这些骨性标志点标出来。
不能给的,是皮肉。 同样的颅骨,软组织厚一点还是薄一点,出来的就是两张脸。公开的颅面复原方法里,软组织厚度取的是人群统计值——用一大批人的测量数据,去推「这个头骨在这个人群里,最可能长成什么样」。
所以复原图给的,是概率意义上的脸:在这套统计模型下最像的一张。它不是照片,也不是画像,它是一份带误差范围的推断。
2018 年那篇报道写得很直白:这张计算机生成的肖像,「只能靠猜测来推断发型和眼睛颜色等细节」。发型、发色、肤色、眼睛颜色、有没有胡子——这些全是猜的。而昨天全网讨论的「像不像张鲁一」,恰好全落在这部分。
四、我们做了一次实测:模型看得出「假」,看不出「谁」
写这篇之前,我把这张配图发给视觉模型,问了两个问题。结果挺有意思。
第一个问题,发给全图:这是什么?真人照片、实验室复原图,还是自媒体海报?
模型的判断是「自媒体合成海报」,并且把图上六行字逐条读了出来。它给的理由是:面部皮肤平滑、光影均匀、五官呈建模感;纯黑背景配黄白大字,是短视频封面排版;缺少实验室颅面复原图应有的科学标注、比例尺、颅骨叠加或灰度分析。
第二个问题,把脸裁出来单独发:这更像真人照片,还是计算机生成的头像?
模型答「计算机生成/三维复原的头像」,依据是毛发呈块状、缺丝状细节,皮肤过于平滑,五官对称得过于规整,确信度「高」。
这两次回答拼在一起,说明一件事:模型能识别「这是生成的」,但识别不了「这是谁」。
它一眼看出这是 CG,却没有任何办法告诉你这张脸属于谁、推断得对不对。这正是这类图片最容易被误传的地方——它不糊、不崩、不穿帮,它只是没有出处。而「没有出处」这件事,模型看不出来,只有人会去查。
五、转发之前,问三句话
第一句:图上的字写的是「真实样貌」,还是「复原/推测/模拟」? 这一张写的是「秦始皇真实样貌」。六个字,把一份带误差范围的推断,说成了定论。
第二句:被复原的是谁,被推断的又是谁? 这次是复原儿子、推断父亲。中间隔着一代人。
第三句:这事是哪一年的? 搜一下关键词加年份,往往三秒就有答案。这一次,答案是 2018 年 7 月。
这套技术当然有用。2018 年的报道里就写了,同一套软件「被公安部广泛用于犯罪调查」——颅骨到面容的低成本初筛,价值在于缩小范围,不在于锁定某个人。把它当成「看见死人长什么样」的魔法,是高估;把它当成「给侦查提供一条线索」的工具,才是它真实的位置。
AI 能把一张脸做到「像」,这已经不难了。难的是另一件事:判断这张脸是谁、能不能信、该不该转。这件事,模型帮不了你。
如果你对「怎么看出生成内容」感兴趣,可以看这两篇:AI 能识破假视频的四个技巧,以及AI 帮英烈「找回」面孔时,人在做什么。前者讲怎么识别,后者讲复原这件事里,「人」为什么不能退场。
Q:秦始皇儿子的这张复原图是假的吗?
不是假的,但也不是「照片」。它是西北大学团队用颅面复原技术做出的计算机肖像:颅骨提供骨相约束,软组织厚度取自人群统计值,发型、发色、眼睛颜色等细节只能推测。它是一份概率意义上的推断,不是实拍,也不是画像。
Q:为什么说这是八年前的旧闻?
2018 年 7 月 16 日,参考消息网转载《南华早报》报道,已经公开了同一具头骨的复原结果。墓葬位置(上焦村)、右颞骨青铜箭头、头与四肢分离、30 岁上下、橄榄形眼睛、隆起的鼻子,六项细节与今年 11 月 8 日的报道逐项吻合。今年是新报道,不是新成果。
Q:AI 复原古人的长相,到底靠不靠谱?
分两件事看。骨相层面相对可靠:眼眶、鼻根、颧骨、下颌这些骨性标志点是实测的。皮肉层面不可靠:软组织厚度是统计平均值,同一副颅骨可以对应很多张脸。所以它能用来缩小范围、辅助辨认,不能用来认定「这就是他本人」。
Q:视觉模型能分辨复原图和真人照片吗?
能分辨「是不是生成的」,不能分辨「是谁」。实测中,模型对全图判定为「自媒体合成海报」,并指出缺少比例尺、颅骨叠加等专业标注;对裁出的脸判定为「三维复原头像」,依据是毛发块状、皮肤过平滑、对称性过强。但它无法判断这张脸属于谁、推断是否成立——那需要人去查出处。


评论