先说一个可能颠覆直觉的事实:12GB显存的显卡,在今天只是一台中端游戏PC的配置。而就在10月6日,科技媒体gigazine报道,开发者Niko1221开源了一个叫Strata的推理引擎,让量化后的Qwen3.8-Flash-Next——一个1250亿参数的大模型——在这档显卡上跑了起来。
我把IT之家、凤凰网科技等几篇报道翻了一遍,把关键数字整理出来:在RTX 5070(12GB显存)+ Ryzen 5 7600 + 64GB内存的平台上,2比特量化版Q2_0达到每秒94个词元,3比特版IQ3_S为每秒53个词元;AMD RX 9070 XT(16GB显存)环境下Q2_0也有每秒60个词元。最低门槛是:12GB以上显存的N卡或A卡、32GB以上内存、80GB以上存储空间(推荐SSD)。
为什么12GB能装下125B?
很多人的第一反应是:1250亿参数,怎么塞进12GB?这不合常理。
关键在于这个模型的出身。Qwen3.8-Flash-Next是阿里Qwen团队今年8月推出的多模态混合专家模型(MoE)的压缩版本。MoE架构的特点是:参数总量很大,但每次推理只激活其中一小部分"专家"。这就给了Strata可乘之机——它做了两件事:
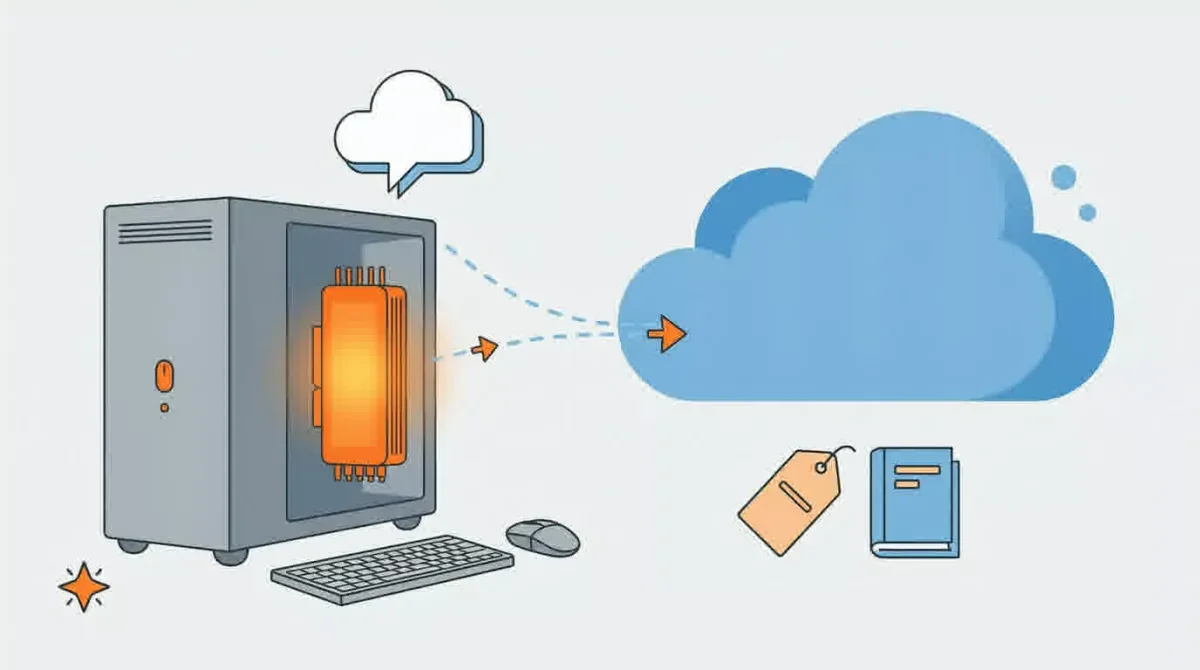
第一,把整个MoE模型放进内存(RAM),只把高频使用的专家模型放进显存(VRAM)。打个比方:整套藏书放在你家仓库,书桌上只摆最近常翻的几本。仓库大(32GB内存)比书桌大(显存)便宜得多,这就是"以内存换显存"的账。
第二,用一个轻量模型做投机解码,先预测下一个词元,再由大模型验证。相当于实习生先写草稿、专家快速过目,多数时候草稿能用,速度就上去了。
代价是什么?
天下没有免费的午餐,这条路线的代价明明白白写在数字里:Q2_0是2比特量化,模型精度被压得很低;IQ3_S是3比特,速度掉到53词元/秒,但报道认为它兼顾速度与质量,更适合大多数用户。
换句话说:显存不够,精度来凑。你得到的是"能跑",不是"满血"。另外别忘了那80GB存储和32GB内存——它降低的是显卡门槛,抬高的其实是整机门槛。
对普通人意味着什么?
我理解这件事的真正意义,不在于"你今晚就去装一个",而在于一条清晰的趋势线:大模型本地化的硬件门槛,正在以肉眼可见的速度下探。
本地跑模型有三样云端给不了的东西:数据不出门(隐私敏感场景的刚需)、零词元费(重度使用者的成本账)、断网可用。但也要实事求是:量化压缩后的本地模型,能力上限和云端旗舰仍有差距,适合固定、重复、隐私优先的任务,不适合追求最强推理的场景。
所以我的建议是分两步走:想尝鲜但硬件不够的朋友,先用线上工具把需求验证清楚——我在spark1.cn的/tools/里整理了各类AI工具的入口和说明,/toolchains里还有按场景串好的工具链,比如"写稿""做图"各用哪个、按什么顺序用,不用自己一个个试。等哪天你确认"这类任务我每天都在做、且不想让数据出门",再考虑本地部署,那时Strata这类引擎大概率已经更成熟了。
技术往下走,门槛往下掉,选择权往上走。你不需要追每一个热点,只需要在门槛掉到自己够得着的时候,从容接住它。
本文素材综合自IT之家、凤凰网科技、太平洋科技等公开报道。


评论