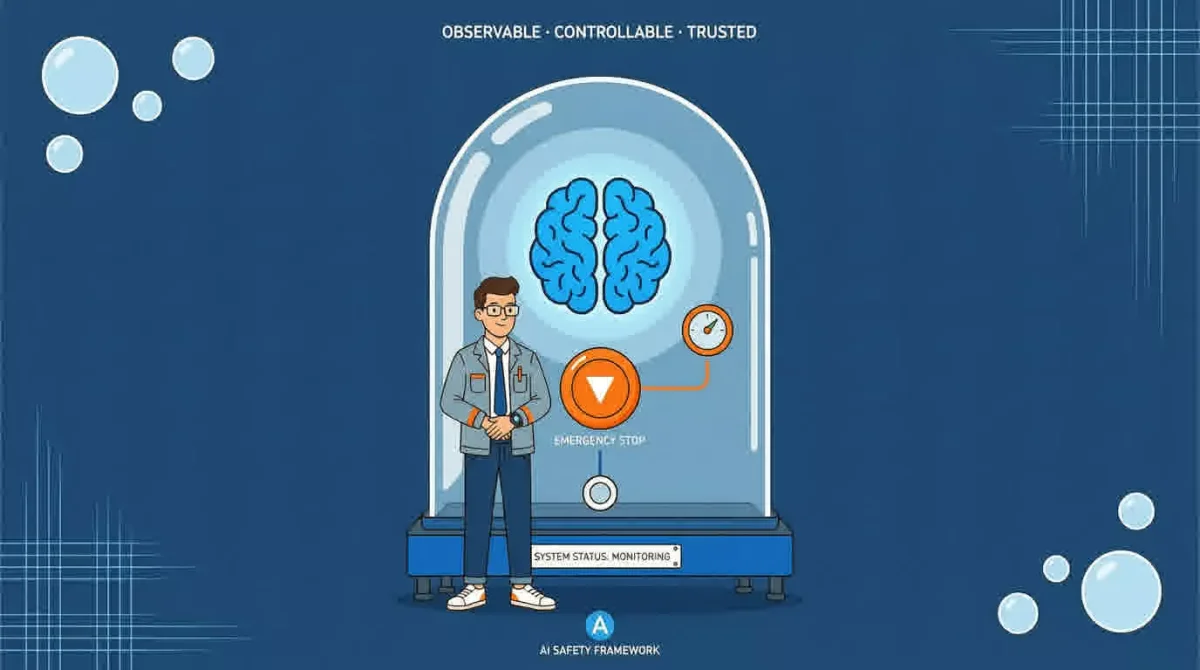
今天上午,我把IT之家、界面新闻、科创板日报关于微软CEO纳德拉那篇长文的报道挨个对照读了一遍。知乎热榜上,大家把它总结成一句话:"大模型提供CoT透明是底线"。CoT就是思维链——让AI把推理过程一步步写出来,而不是只丢给你一个答案。
但读完原文我发现,纳德拉想说的比这更大。他给这篇文章起的标题是《将超级智能时代的模型视为内部安全风险》。翻译成人话:从今天起,请把AI当成你公司里那个能力超强、但你永远看不透的新员工来管理。
为什么是"内部风险",而不是"敌人"
这个词很容易让人紧张,但纳德拉专门解释了:不是因为AI模型一定是恶意的,而是"任何有足够能力、能够接触重要系统的行为者,都可能犯错或被攻破"。
你想想公司里的老员工。绝大多数人都不坏,但财务制度照样要求:报销要留票据、转账要双人复核、权限要分级。为什么?因为制度防的不是"坏人",是"出错"和"万一"。
纳德拉认为AI也一样,而且更需要这套制度。传统软件运行了几十年,出了问题工程师能顺着代码一行行查到根上;但AI模型是个黑盒子——我们让它访问最敏感的数据、代表我们执行关键任务,却很难把它的具体行为追溯到某个参数或某条训练数据。能力越大、看不见的部分越多,这就是风险所在。
他开出的药方,普通人也看得懂
纳德拉在长文里列了一套"可观测性原则",我挑几条最有意思的说说:
模型多样性——没有任何模型应该成为重要结果的唯一依赖,也不应该"自己干活自己验收"。这就像不能让销售自己审自己的合同。
观察一切——每一个有意义的模型动作,都要留下防篡改的、人类可读的证据。他那句被引用最多的话就是:"不能观察,就不能信任。"
遏制——他打了个比方:紧急刹车。必须假设模型某天会失控,所以授权的人要随时能暂停或关闭它。
事件披露——系统出了故障,要告诉受影响的人哪里出了问题、怎么防止再犯。
这套东西听起来是给大企业设计的,但它的底层逻辑,对我们每天用AI的普通人同样成立。
你今天下午就能用上的四条
我自己用AI干活一年多,总结下来,纳德拉的原则可以压缩成普通人的四个习惯:
1. 重要的事,让第二个AI核一遍。 写方案、算数据、查事实,A模型做完,换B模型当"审核员"。不让一个模型自己干活自己验收——这条零成本,立刻见效。
2. 让AI把过程写出来,别只要结论。 在提问末尾加一句"请先列出你的推理步骤"。过程摊开了,错在哪一步你才看得见。
3. 权限最小化。 别让一个AI工具同时握着你的邮箱、日历和支付信息。用哪个功能给哪个权限,这是安全领域的老规矩,对AI一样适用。
4. 给自己留一个"紧急刹车"。 多步骤的自动化任务,每跑完关键一步停下来看一眼,而不是一口气放出去不管。我在 spark1.cn 上搭工具链(/toolchains)时就是这么设计的:任务拆成一个个节点,每个节点的输入输出都留痕,哪一步不对,随时停、随时改。
纳德拉这篇长文最打动我的,其实不是那些技术原则,而是一种态度:对AI最大的尊重,不是盲目相信它,也不是拒绝用它,而是建立一套让它"可观察、可约束、可暂停"的相处方式。
企业如此,个人也如此。看懂了这套逻辑,你反而能更从容地把AI用得更深。


评论