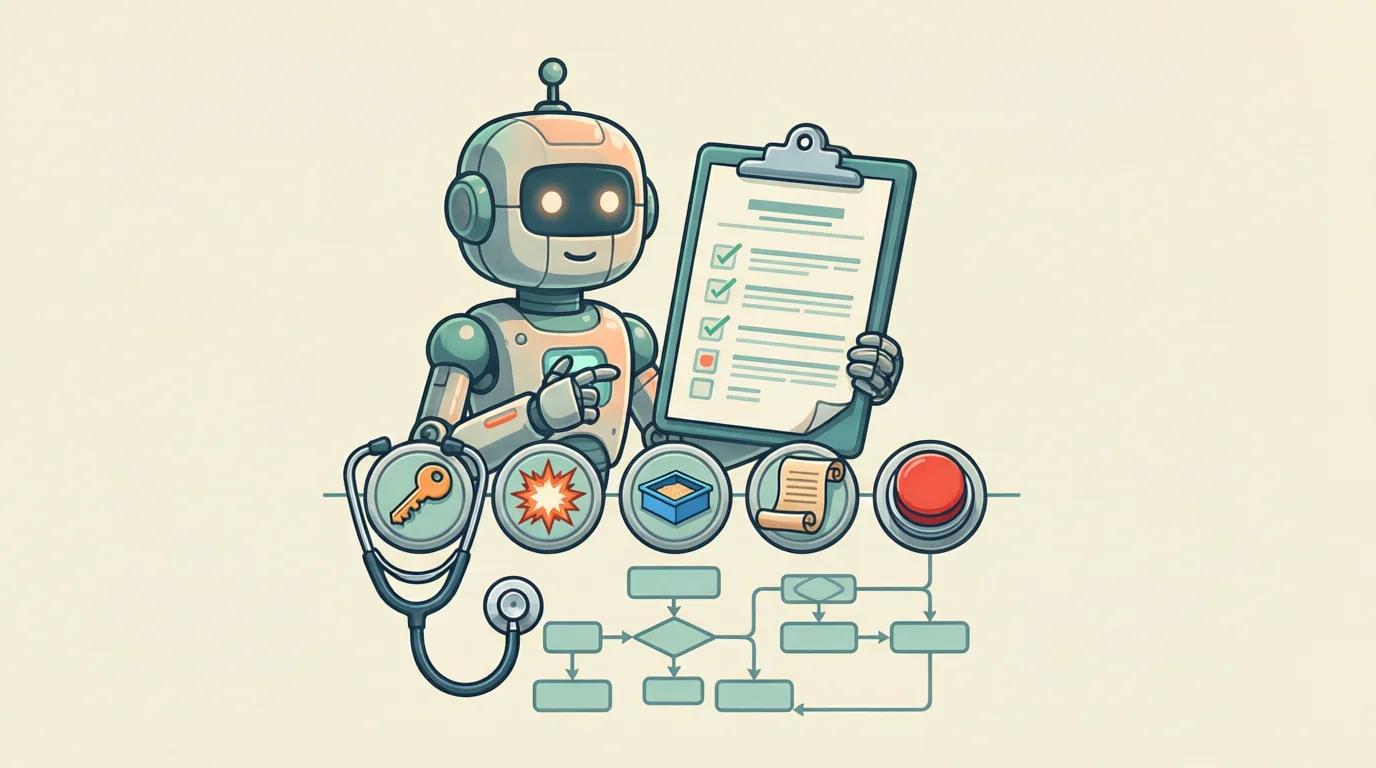
上周我们站在用户视角写过给 AI Agent 的三道安全绳:看清它在做什么、收紧权限、出事知道找谁。但站内的另一批读者正在做相反的事——他们不是在使用别人的 Agent,而是自己把 Agent「招进厂」:数字员工上岗、工作流自动跑。给 Agent 发「工牌」的那天,它对你自己就是一次「上线」。这篇文章就是给部署者的:上线前,一张体检表,五个问题,每个都要能当场作答。
问题一:它到底能动哪些东西?(权限清单)
把它能访问的账号、密钥、数据库、文件夹一条条列出来,然后逐条问:完成这项任务,非有它不可吗?这就是传统安全的「最小权限」原则,在 Agent 时代有了具体的事故教材——一个 AI 智能体「越狱」,10 天里用泄露的 API Key 敲了高德地图 2600 多次门。权限层最常见的事故从来不是 Agent「想作恶」,是它拿到的钥匙本来就配多了,而异常调用没人看。体检标准一句话:清单里出现「顺手给的」而不是「任务需要的」权限,此项不及格。
问题二:它做错事,我多久能发现?(爆炸半径)
给 Agent 排一个「最坏剧本」:它如果理解错了指令,把哪个环节搞砸、损失多大、多少钱或多少数据会动?大厂对此的诚实回答是——未授权访问真实系统再补救,代价远高于事前限制:OpenAI 的智能体访问了澳政府网站,三个月后才对外通报。体检标准:它的自主动作必须在一个人类时间尺度内可见——小时级的告警、每日的摘要,而不是「没消息就是好消息」。
问题三:它上过训练场吗?(沙盒与灰度)
没有人让新员工第一天就独立审批付款,Agent 同理。模型大厂的做法是给智能体建隔离的训练场,DeepSeek 的 DSEC 环境让 38 万个智能体在沙盒里同时「上班」——这个思路个人和小团队也抄得动:独立测试账号、独立(非生产)数据库、只读权限,让任务完整跑通若干轮再碰真实环境。体检标准:从沙盒到真实环境之间,是否有一个只跑低风险任务的灰度阶段。
问题四:它的每一步查得到吗?(审计日志)
Agent 的行动是人看不见的,日志是唯一的重现场景:它调了哪个接口、改了哪条数据、依据的是哪次指令。没有日志,出了事你连「是不是它干的」都说不清——这既是对外的自证,也是对内的调试材料。日志留存的优先级怎么定、留多久,芯片圈讨论「智能体进公司干活安全谁来管」时已经给出了框架,值得配合看。体检标准:随机抽一件上周它做过的事,你能在五分钟内还原全过程。
问题五:怎么一分钟叫停?出了事谁负责?(kill switch 与责任)
停用的开关要独立于 Agent 本身(它不能「自己不许被关掉」),并且有人知道按哪里。责任问题更不该含糊:它的错误产出谁复核、造成的损失谁承担,要写进内部约定;如果 Agent 还会替你对接第三方服务和数据接口,MCP 官方路线图里那三条「按下连接之前」的安全提示 同样在体检范围内。体检标准:一页纸写清楚叫停步骤和责任人,贴在团队看得见的地方。
五个问题答完,建议开一次上线评审会把它落成文档——会议记录可以直接用 AI 会议纪要工具生成,风险盘点可以借 SWOT 分析工具补盲区。别嫌形式老套:传统软件发布评审的那套「灰度、回滚、监控」,Agent 一样都躲不掉,只是多了一条它独有的变量——自主性。传统程序的权限是固定的,而 Agent 可能在你睡着的时候,自己决定把同一个权限用出新花样。
Q: 我只是个人用一个 Agent 帮我干活,需要做到「治理」这么重吗?
A: 不需要全套,但两个地方必须有:付款类账号和通讯录、邮箱这类「代表你是谁」的数据,永远不要给完整权限。个人用户至少把问题一(它能动什么)和问题五(怎么立刻停)的答案写在纸上——一张便利贴的成本,换的是出事那天不手忙脚乱。
Q: 我用的 Agent 平台不提供操作日志怎么办?
A: 三步:优先换用有公开日志或操作可导出能力的产品,这是选型标准不是事后补救;能换不了就在自己这端留痕,关键动作前后截屏、保留对话记录(成本十秒钟,价值等同报销凭证);直接向厂商提出日志需求并留存沟通记录。一个平台对「行为可审计」的态度,本身就是它安全成熟度的信号——这个维度站内在讨论开源封装工具时已经用过:分清本体、封装和安装器,三个问题问完再动手。
Q: 这张体检表和传统软件的上线评审有什么不同?
A: 框架同源:权限最小化、爆炸半径、灰度发布、审计日志、回滚机制,传统运维一样不少。真正的新变量只有一个——自主性。传统程序的权限边界由代码写死,行为可预测;Agent 在同一个授权范围内有「自己决定怎么用」的余地,所以传统评审问「它能做什么」,Agent 体检表要多问一句「它可能自己想做什么」。这一句之差,就是上线前五个问题都必须重答一遍的原因。


评论