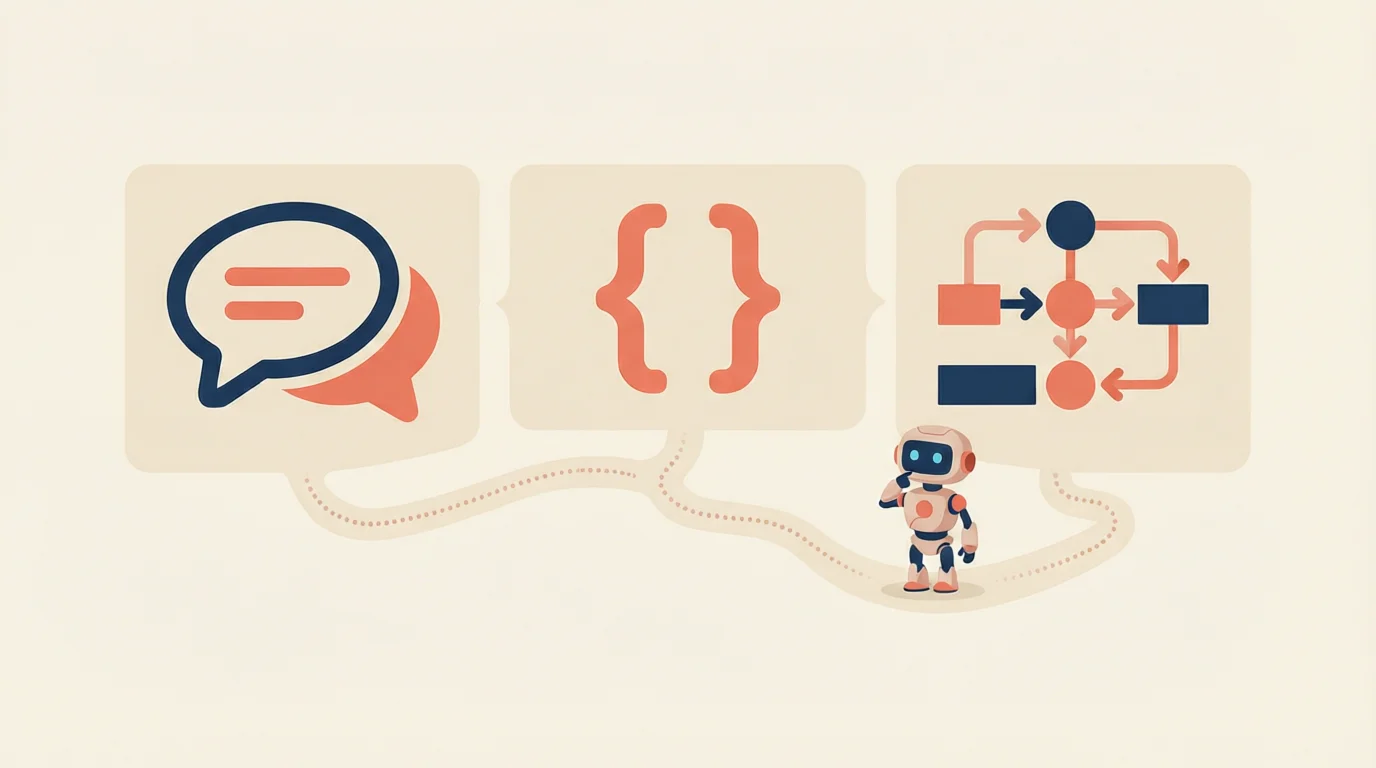
Agent 平台这两年冒出来一大批。名字不一样,宣传词却差不多:能替你干活、能自己规划、能调用工具。真到要选一个的时候,问题往往不是"谁最强",而是"我要它做什么、我愿意给它多少权限"。
这篇不做好坏排名,只给一套能自己用的判断方法。
一、先把平台分三类
不同平台解决的是不同问题,混在一起比没有意义。
- 通用助理型:你说目标,它自己拆步骤、找工具、交结果。适合"这件事流程不固定"的场景。
- 编码型:在终端或编辑器里读代码、改文件、跑命令。适合有仓库、有明确产出的开发任务。
- 工作流型:你把触发条件、步骤、输出格式画成一串,它按串执行。适合"每天/每周都要重复"的固定流程。
拿工作流型的标准去要求通用助理,会觉得它怎么老跑偏;拿通用助理的标准去要求工作流,又会觉得什么都要自己配。先定位类别,再比细节。
二、五个判据,按顺序问自己
第一,执行过程能不能核对。 它做了哪几步、调用了什么、改动了哪些文件,能不能在事后翻出来。能核对,出问题才找得到原因;不能核对,就只能看它最后交出来的结果。
第二,权限边界清不清楚。 它只能读,还是也能写、能发、能付款。能只读就别给可写——这是所有"AI 替你办事"的第一原则。
第三,失败时能不能中断、能不能回滚。 长任务跑到一半发现方向错了,你有没有一个按钮能让它停下来,改动能不能撤回。没有中断机制的平台,只适合短任务。
第四,钱怎么算。 按次、按 token、按月订阅,三种计费方式对使用习惯的影响完全不同。高频短任务和低频长任务,适合的模式不一样。
第五,数据落在哪。 你的文件、对话、账号信息存在哪一端,能不能删干净,能不能私有化部署。这一条对个人用户常常被忽略,对团队则是第一道门槛。
这五条不需要懂技术就能判断。逐条打分,比看宣传页有用。
三、站内那份月度榜,该怎么看
站内有一个 AI Agent 专栏,每月更新一份全球 Agent 榜单,数据从公开信息整理。2026 年 9 月这一期的前十名是:Claude Code、OpenAI Codex、Cursor、OpenCode、Gemini CLI、Cline、n8n、扣子 Coze、Dify、Lindy AI。
用这份榜之前,先说清两点:
- 它是"关注度与综合表现"的整理,不是"最好用"的评测。排在前面,不等于适合你的场景。
- 前十里有六个属于编码型,是因为过去一年这一类公开讨论最集中,不代表普通人该优先选编码型。
正确的用法是:先用上面的三类定位自己需要哪一类,再在同一类里看榜单。跨类比较,参考价值不大。
四、国产平台这一边
榜单里出现较多的国产平台是扣子 Coze 和 Dify。前者偏"搭一个能对话的应用",后者偏"自己部署一套工作流",都能从零开始,也都需要你先想清楚要解决哪个具体问题。
一个常见误区是把它当成"功能越全越好"。平台功能多,不等于你上手快,反而容易在配置里绕不出来。更实际的做法是拿一个真实的小任务试:一件你每周都要重复做的事,从触发到产出的全流程能不能跑通。跑不通,再全的功能也帮不上忙。
五、普通人的选择顺序
- 先写清楚一件事:你希望它替你做的那件事,输入是什么、输出是什么、多久做一次。
- 再看站内 AI百宝箱 里有没有现成的单点工具。很多"想用 Agent 解决"的事,一个工具就够了。
- 只有当这件事需要"按条件自动触发、多步串起来"时,才进入平台选型。
- 最后才看榜单和价格。
站内还有两篇可以接着看:AI Agent 的体检表讲的是上线前要回答的五个治理问题,普通人搭建 AI 助手的三种方式讲的是零代码上手的路径。
Q: Agent 平台和聊天机器人有什么区别?
聊天机器人主要回答问题,输出是文字;Agent 平台会拆解任务、调用工具、执行步骤,输出可能是文件、代码改动或完成的操作。区别在于"能不能动手",不只是"能不能答"。
Q: 不懂代码能用吗?
工作流型和通用助理型的平台大多提供可视化配置,不用写代码也能搭出简单流程。但"不用写代码"不等于"不用想清楚",任务的目标、输入、输出还是得自己定义。
Q: 榜单排名高的是不是就该选它?
不是。榜单反映的是一段时间内的关注度和综合表现,不针对你的具体场景。先按类别定位,再看同类里的表现,比直接选第一名靠谱。
Q: 把账号权限交给 Agent 安全吗?
取决于你给多少。能只读就别给可写;能限定范围就别给全量;给之前先确认有没有撤销入口。权限给出去再收回,也不等于没给过。


评论